Ok, deixe- me compartilhar alguns conceitos que eu realmente acho interessantes aqui, porque o 'construir sua própria ferramenta de IA' ainda parece mais complicado do que é. Muitos destes são apenas alguns serviços conectados da forma certa, e a parte engraçada é que você já pode construir algo realmente útil antes mesmo de entender completamente o que todas as peças fazem.
Começaria com coisas que resolvem um problema irritante primeiro. Não o sistema operacional do IA para a minha inicialização. Uma coisa. Faça com que funcione. Em seguida, adicione coisas.
1. Seu próprio cérebro para o feedback dos clientes
Se você estiver construindo um produto, o feedback estará em todo o lugar cedo ou tarde. Tickets de suporte, entrevistas, avaliações, mensagens aleatórias do Slack, notas de vendas, talvez Reddit, qualquer que seja.
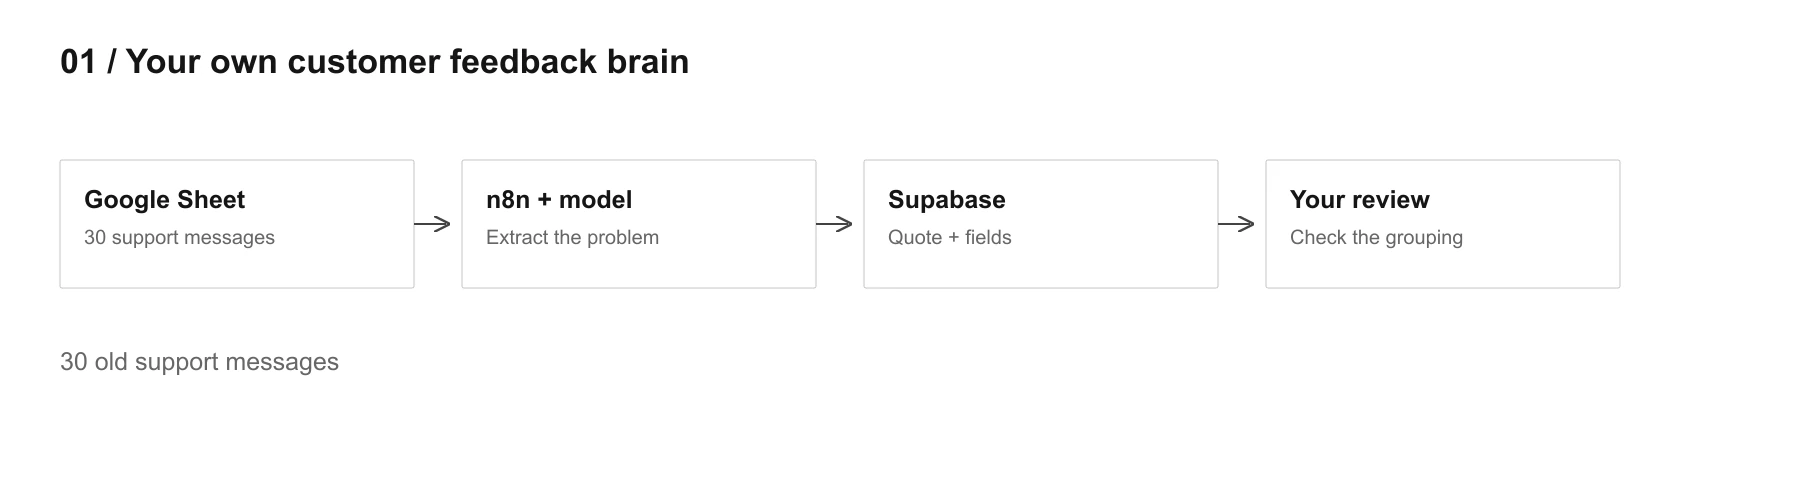
A primeira versão mais fácil seria n8n + Claude/ChatGPT + Supabase.
n8n coleta novos feedbacks, envia- os para o modelo, o modelo extrai alguns campos úteis, então o Supabase armazena tanto o texto original como a estrutura limpa.
Começaria com algo assim simples:
source
original_text
product_area
problem
severity
related_feature
confidence
E sim, mantenha o texto original. Isto importa muito porque, depois de algum tempo, os resumos da IA começam a parecer suspeitamente mais bonitos do que o cliente real.
Leia este feedback do cliente e extraia o problema subjacente em linguagem simples.
Retornar:
product_area
problem
severity de 1 a 5
related_feature se estiver claro
confidence de 0 a 1
Se não tiver certeza, escreva UNKNOWN.
Não invente o contexto que não está no feedback original.
Mantenha a redação original do cliente separadamente.
Por onde começar? Honestamente, pegue 30 mensagens antigas de suporte, coloque- as em uma Folha do Google, execute o fluxo de trabalho nas primeiras. Se o agrupamento parecer estúpido, corrija o prompt antes de conectar cinco fontes diferentes.
Mais tarde você pode conectar Gmail, Intercom, Slack, formulários etc.
2. Um pequeno espião da concorrência
Este é provavelmente ainda mais fácil.
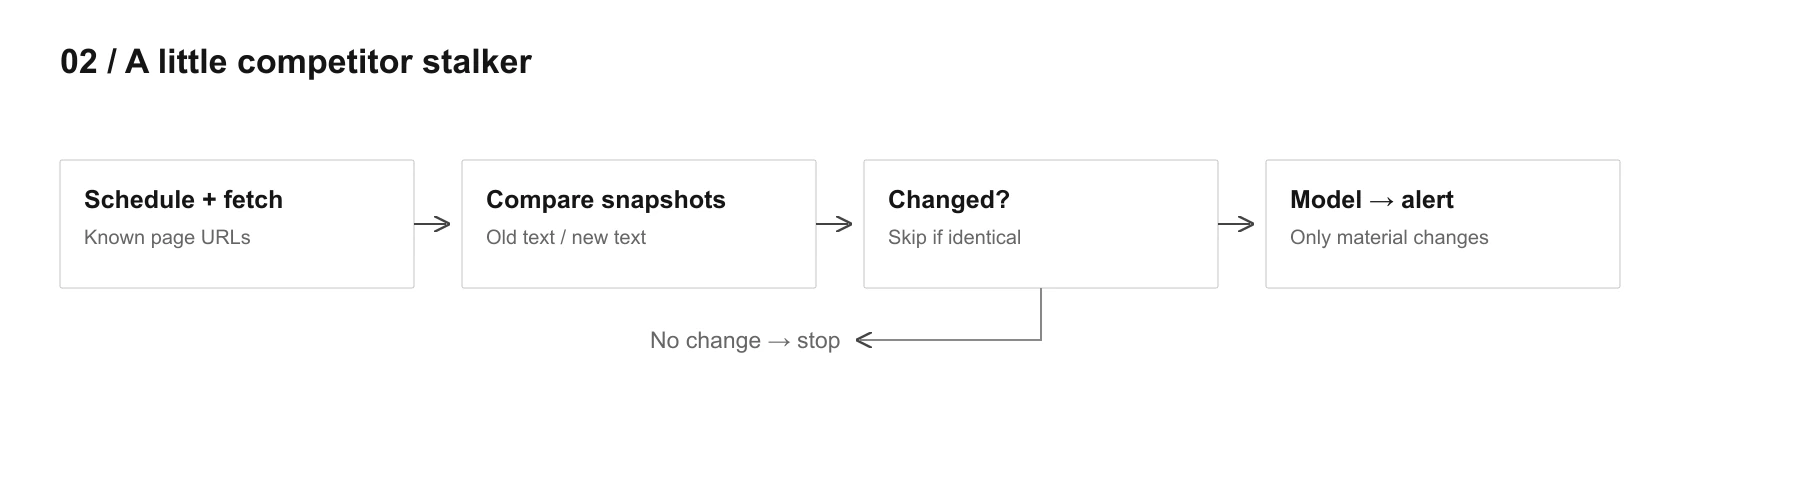
Escolha 5 concorrentes e apenas 2 ou 3 páginas para cada uma no início. Preços, página inicial, registro de mudança. Isso é suficiente.
Você pode usar n8n + uma simples extração HTTP + Supabase para armazenar instantâneos. Todos os dias ou a cada poucos dias, extrair a página novamente e compará- la com a versão anterior. Só se algo mudar, envie o texto alterado para o Claude/ ChatGPT e pergunte se realmente importa.
Eu não enviaria toda a internet para o modelo todos os dias. Isso é desperdício e meio burro.
Compare estas duas versões da mesma página do concorrente.
Ignore pequenas alterações de redação, alterações de formatação e texto legal irrelevante.
Diga-me apenas se algo significativo mudou para produto, preço, posicionamento, a bordo ou cliente- alvo.
Retornar:
changed: true/false
summary
why_it_matters
confidence
No início, o IÏd até pulou o rastreamento chique. Basta adicionar manualmente os URLs que você se importa e ver se os alertas são úteis.
Se, após duas semanas, você receber principalmente lixo, o seu problema não é o de AI. O seu filtragem é ruim.
3. Um assistente de PRD que sabe o que aconteceu antes
Este precisa de um pouco mais de configuração, mas ainda é muito possível.
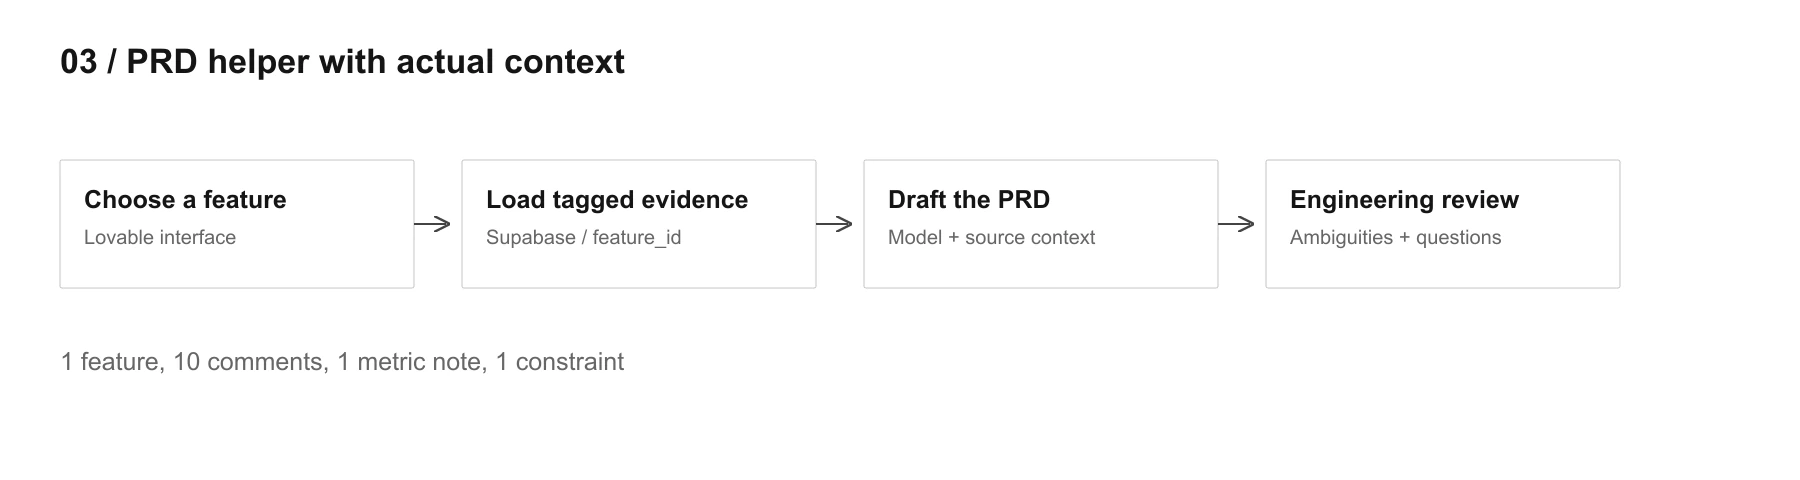
Provavelmente, o id usa o Lovable + Supabase + Claude/ChatGPT, e depois conecta Linear/ Jira ou Productboard.
A versão pequena é basicamente uma página onde você escolhe um recurso, e o aplicativo puxa feedback relacionado ao cliente, notas antigas, talvez comentários analíticos, então envia tudo isso como contexto para o modelo.
Você não precisa de alguma arquitetura de recuperação gênio na versão um. As etiquetas são suficientes.
Então, talvez o feedback tenha:
feature_id = onboarding_v2
e todas as anotações sobre o a bordo estão ligadas a isso.
Em seguida, prompt:
Você está escrevendo um PRD somente a partir de evidências existentes.
Use o feedback do cliente, anotações analíticas e restrições técnicas abaixo.
Não invente os requisitos.
Marque claramente os pressupostos.
Se faltar algo importante, crie uma OPEN QUESTION em vez de adivinhar.
Depois do rascunho:
Leia este PRD como um engenheiro que nunca viu a funcionalidade antes.
Aponte tudo o que possa ser entendido de duas maneiras diferentes ou não possa ser implementado sem outra decisão.
Honestamente, essa segunda indicação é provavelmente onde a maior parte do valor está.
Inicie com uma funcionalidade manualmente. Coloque 10 comentários no Supabase, adicione uma nota analítica, uma limitação de engenharia, em seguida, genere o PRD. Se isso já se sentir útil, conecte o resto.
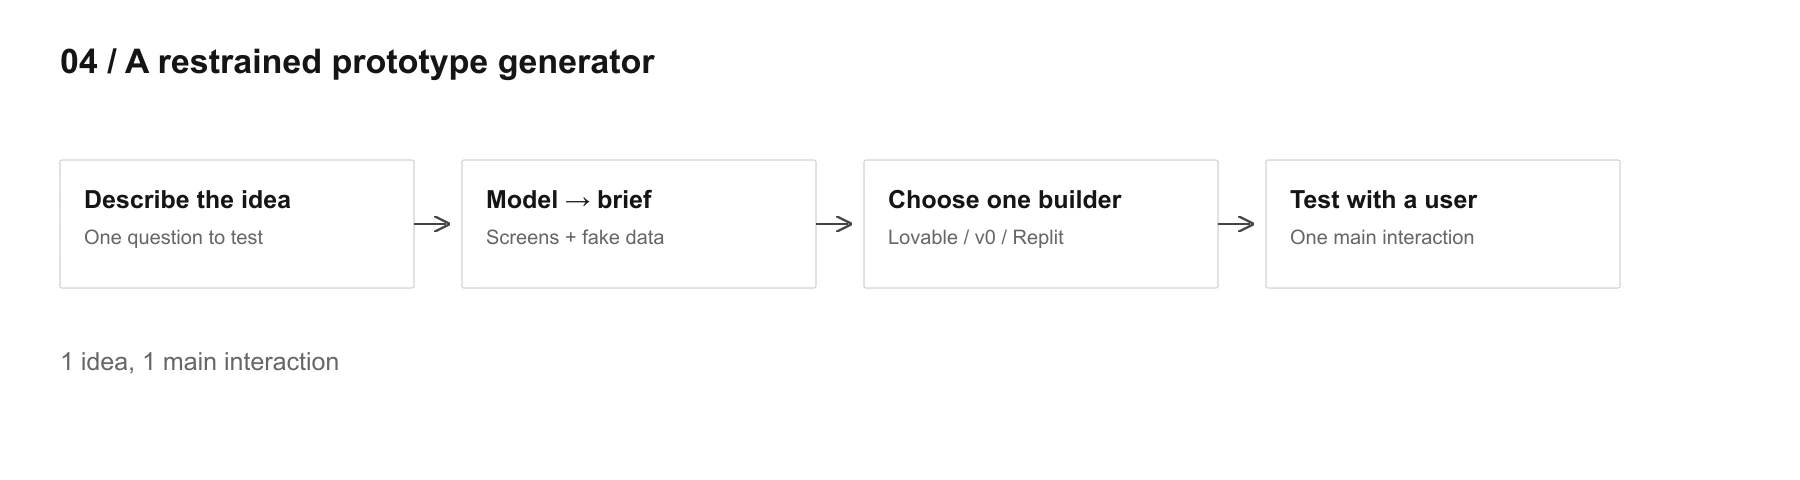
4. Um gerador de protótipos, mas com limites
Este é menos a automação do fluxo de trabalho e mais um pequeno produto para si mesmo.
Usar Lovable, v0 ou Replit e construir uma interface muito pequena com:
uma área de texto para a ideia
Talvez algumas opções como móvel/web/padrão
botão: gerar protótipo breve
Eu realmente não tentaria fazê- lo gerar automaticamente o aplicativo inteiro a partir do primeiro dia. Primeiro, fazer que ele gerasse uma especificação muito estrita que você então alimentava em Lovable/ Replit.
Eu quero testar esta ideia: [IDEA]
Crie o menor protótipo clicável possível que me permita testar a interação principal com um usuário.
Usar dados falsos.
Não adicione faturamento, configurações, painéis de administração, notificações, papéis ou outras funcionalidades secundárias, a menos que sejam necessários para o teste.
Dê-me:
telas necessárias
o que acontece em cada tela
amostra de dados falsos
o que pode permanecer completamente falso
Que pergunta este protótipo deve me ajudar a responder
Então você cola o resultado em Lovable ou Replit.
Desta forma, você está usando IA duas vezes: primeiro para reduzir a idéia para a menor coisa testable, então para realmente construí- la.
E sim, este é um desses casos em que manter a IA sob controle é mais útil do que pedir para ser criativo.
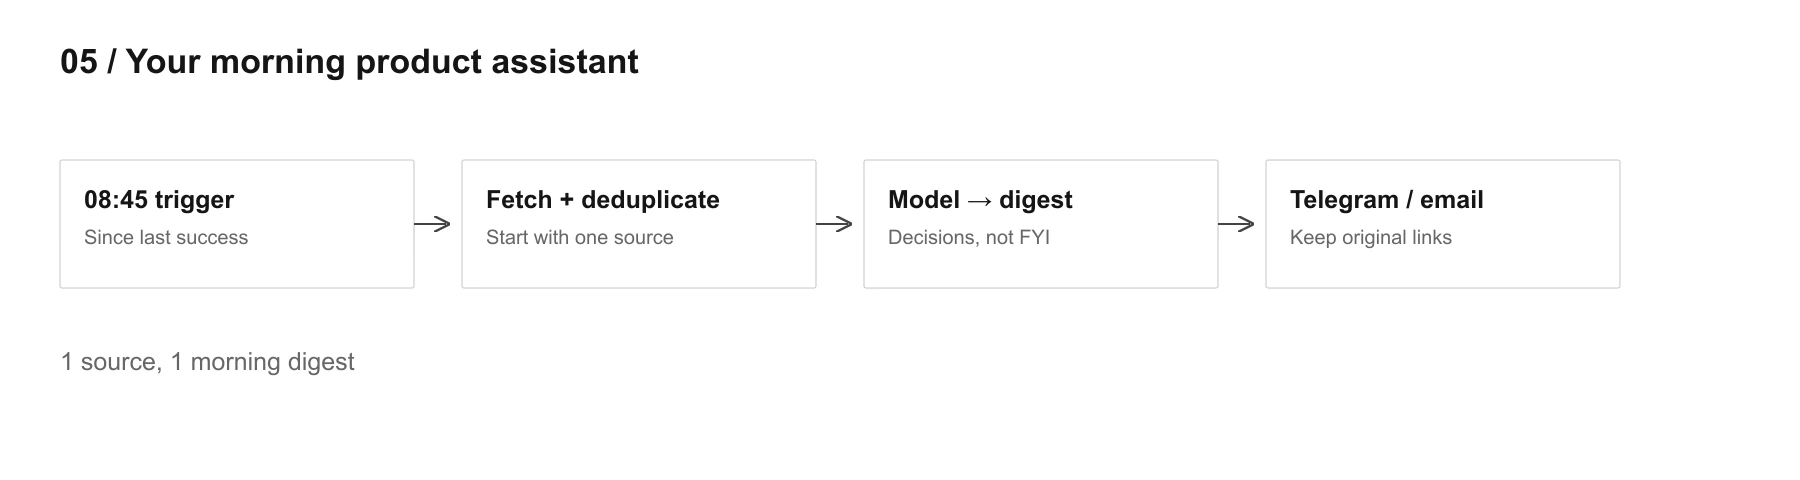
5. Seu próprio assistente de produto para as manhãs
Este é provavelmente o mais fácil de usar todos os dias.
Comece com apenas Gmail + Linear/ Jira, ou apenas Slack se isso é onde a maior parte do caos acontece. Não conecte 12 coisas imediatamente.
Use n8n em um cronograma, talvez 8: 45 todas as manhãs, puxe novos itens desde ontem, envie- os para o modelo, em seguida, entregue um digest para o Telegram, Slack ou e- mail.
Resumir apenas as coisas que podem afetar as decisões de produtos hoje.
Ignore o ruído e a conversa social.
Mostrar:
bloqueadores
Problemas com os clientes
decisões esperando por mim
alterações importantes desde ontem
Mantenha- a curta. Se nada importante aconteceu, diga isso.
Então, mais tarde, você pode adicionar a parte do fim do dia.
Algo como:
Com base nas tarefas, anotações e decisões de hoje, me diga o que realmente mudou.
O que aprendemos?
Que suposição ficou mais fraca?
O que ainda não deve ser decidido?
Guarde isso para Noção ou Supabase e, de repente, você tem este diário de produtos estranho crescendo no fundo.
E honestamente, eu comecei com a parte da manhã apenas. Se ela salvar você 20 minutos por uma semana, em seguida, adicione mais.
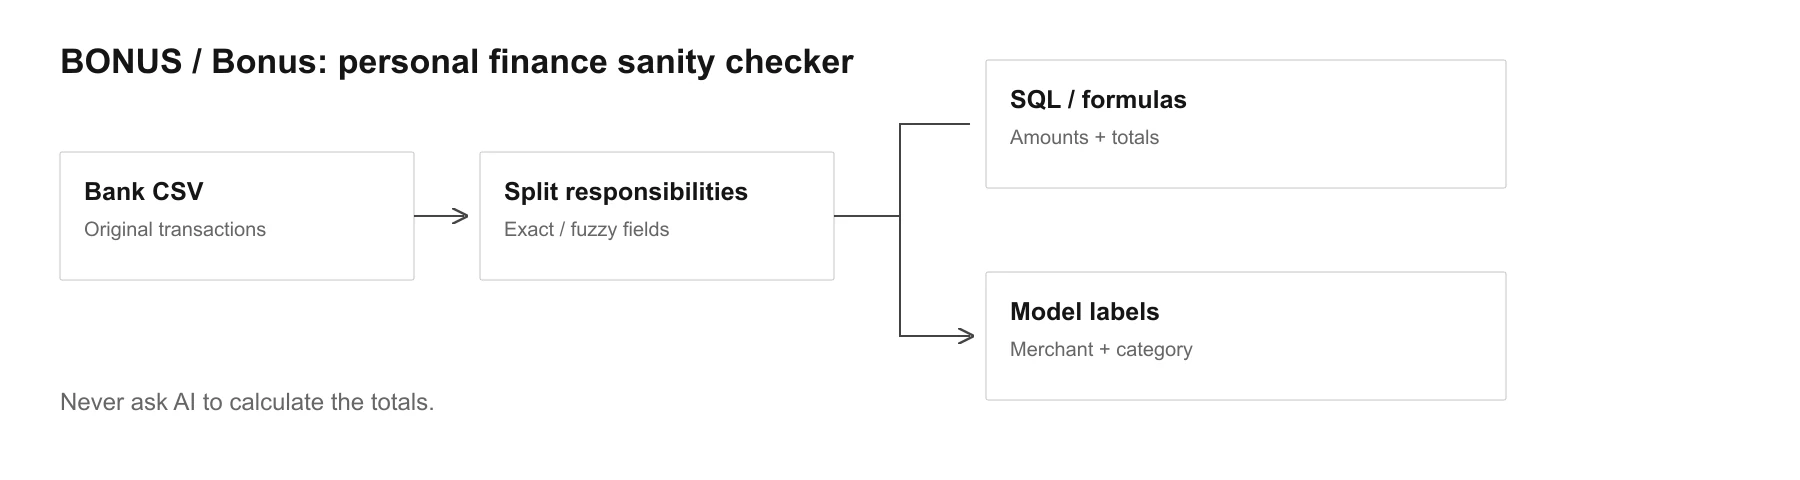
Bônus, porque ainda quero muito este: um verificador das suas finanças pessoais
Isto provavelmente é Folhas do Google ou Supabase + n8n + LLM.
Exportar transações bancárias como CSV. Coloque- as em uma tabela. Use fórmulas normais ou SQL para todos os totais exatos. Deixe a IA limpar nomes de comerciantes e classificar descrições estranhas de transações.
Por exemplo:
AMZN Mktp DE*8H2... → Amazon
GOOGLE *TEMPORARY HOLD → probably temporary hold
some completely cursed bank merchant string → maybe restaurant / transport / subscription
Classifique esta transação com base no nome e descrição do comerciante.
Retornar:
normalized_merchant
category
recurring: true/false/unknown
confidence
Não estime a quantidade, a data ou a moeda. Estes vêm dos dados originais da transação.
Então seu painel pode calcular exatamente as coisas chatas e a IA pode ajudar a responder a perguntas humanas como:
o que se tornou notávelmente mais caro este mês?
Quais as despesas recorrentes apareceram recentemente?
quais nomes de comerciantes se parecem com a mesma empresa sob descrições diferentes?
Começaria com 2 ou 3 meses de dados. Isso é suficiente para ver se a categorização é realmente útil.
E eu acho que é tipo o padrão geral para todos estes.
Não comece por perguntar: Que arquitetura completa preciso?
Comece com:
que coisa irritante quero parar de fazer manualmente esta semana?
Em seguida, construir a versão estúpida primeiro.
30 mensagens de feedback.
5 URLs concorrentes.
1 recurso PRD.
1 protótipo.
1 digestão matinal.
Se isso já se sentir útil, então sim, agora faz sentido torná-lo maior.