Ok, laissez-moi partager quelques concepts que je trouve en fait intéressant ici, parce que «Construire votre propre outil d'IA» sonne encore plus compliqué qu'il est. Beaucoup d'entre eux ne sont que quelques services connectés de la bonne manière, et la partie drôle est que vous pouvez déjà construire quelque chose d'authentiquement utile avant même de comprendre pleinement ce que toutes les pièces font.
Je commençais par des choses qui résolvent un problème ennuyeux d'abord. Pas le système d'exploitation de l'AI pour mon startup. Une chose. Faire fonctionner. Puis ajouter des trucs.
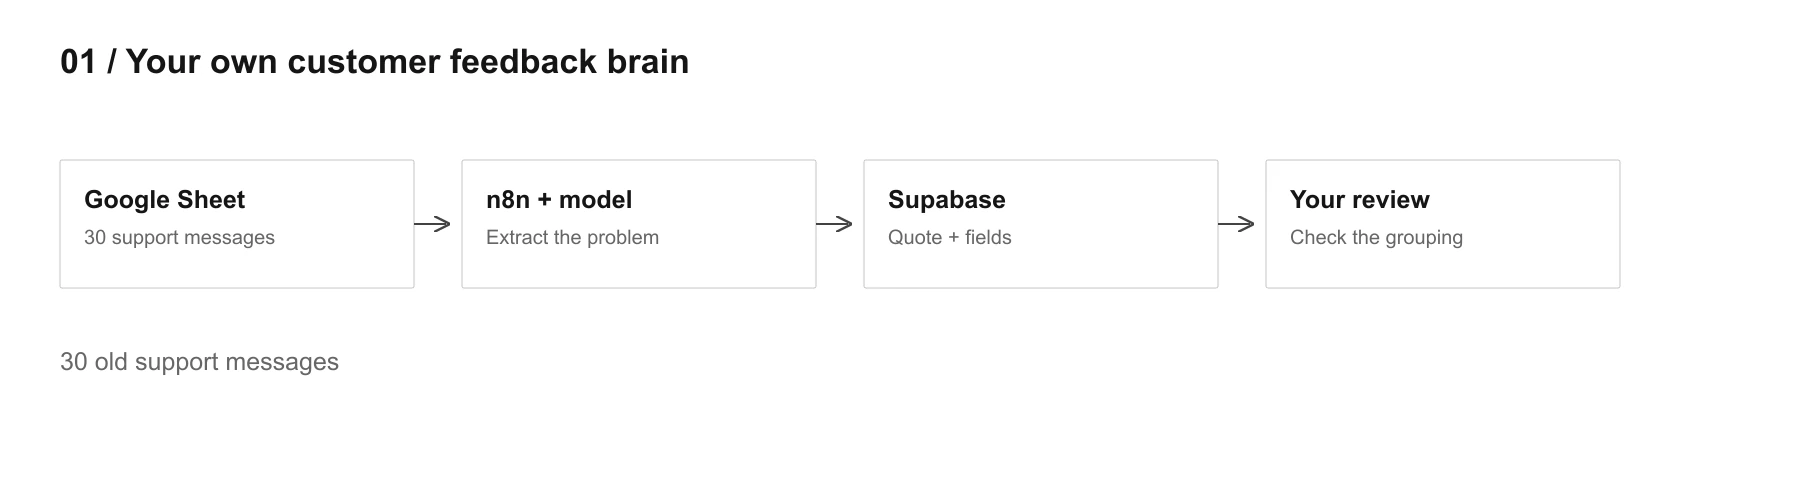
1. Votre propre cerveau pour les retours clients
Si vous construisez un produit, les commentaires seront tôt ou tard partout. Tickets de support, interviews, commentaires, messages aléatoires Slack, notes de vente, peut-être Reddit, peu importe.
La première version la plus facile serait n8n + Claude/ChatGPT + Supabase.
n8n recueille de nouveaux commentaires, l'envoie au modèle, le modèle extrait quelques champs utiles, puis Supabase stocke à la fois le texte original et la structure nettoyée.
Je commencerais par quelque chose de si simple:
source
original_text
product_area
problem
severity
related_feature
confidence
Et oui, gardez le texte original. Cela compte beaucoup parce qu'après un certain temps les résumés d'IA commencent à sonner suspectement plus agréable que le client réel.
Lisez cette rétroaction client et extrayez le problème sous-jacent en langage clair.
Retour & #160;:
product_area
problem
severity de 1 à 5
related_feature si c’est clair
confidence de 0 à 1
En cas de doute, écrivez UNKNOWN.
Ne pas inventer de contexte qui ne figure pas dans la rétroaction originale.
Gardez séparément le libellé original du client.
Par où commencer ? Honnêtement, prenez 30 vieux messages de support, mettez-les dans une feuille de Google, exécutez le flux de travail sur ceux d'abord. Si le groupement semble stupide, corrigez le prompt avant de connecter cinq sources différentes.
Plus tard, vous pouvez connecter Gmail, Intercom, Slack, formulaires etc.
2. Un petit espion de la concurrence
Celui-ci est probablement encore plus facile.
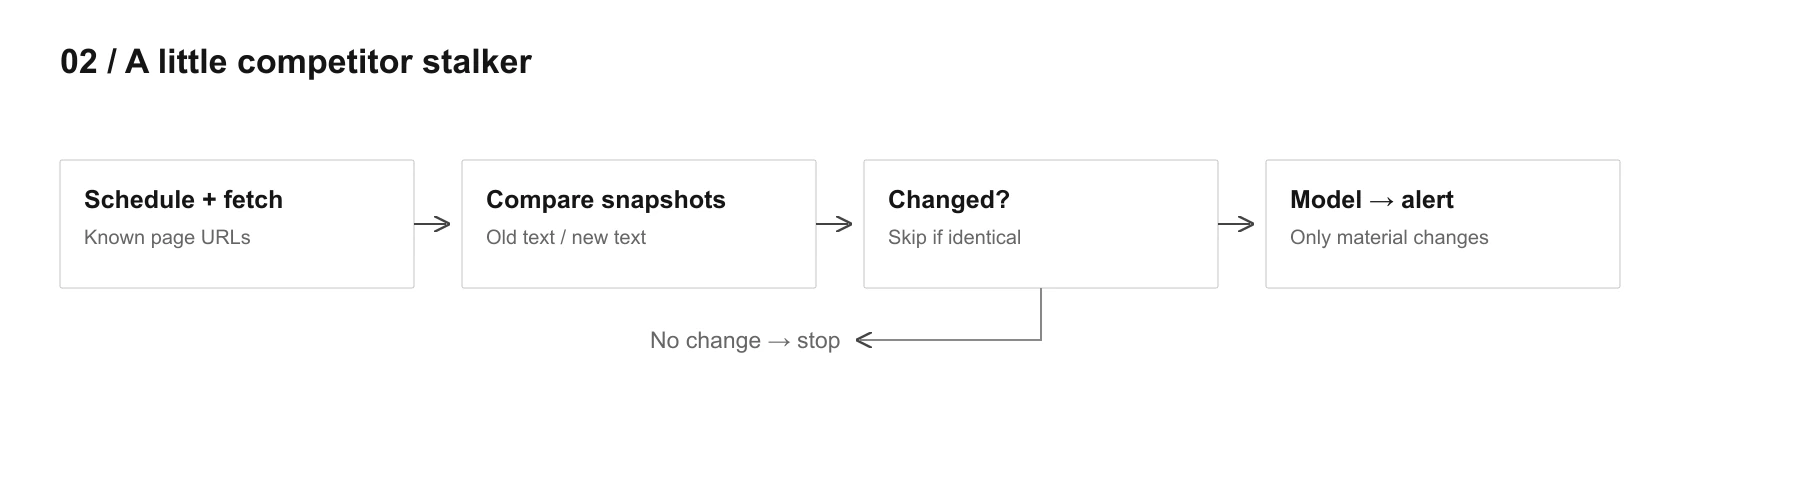
Choisissez 5 concurrents et seulement 2 ou 3 pages pour chacune au début. Prix, page d'accueil, changelog. Cela suffit.
Vous pouvez utiliser n8n + une simple récupération HTTP + Supabase pour stocker les instantanés. Chaque jour ou tous les quelques jours, récupérez la page et comparez-la avec la version précédente. Seulement si quelque chose a changé, envoyez le texte modifié à Claude/ChatGPT et demandez si cela compte.
Je ne voudrais pas envoyer l'internet entier au modèle tous les jours. C'est gaspillant et un peu stupide.
Comparez ces deux versions de la même page concurrente.
Ignorer les changements de libellé minuscules, les changements de formatage et les textes juridiques sans importance.
Dites-moi seulement si quelque chose de significatif a changé pour le produit, le prix, le positionnement, l'embarquement ou le client cible.
Retour & #160;:
changed: true/false
summary
why_it_matters
confidence
Au début, j'ai même sauté le crawling fantaisie. Il suffit d'ajouter manuellement les URLs que vous vous souciez et de voir si les alertes sont utiles.
Si après deux semaines, vous obtenez principalement des ordures, votre problème n'est pas . Nous avons besoin de plus d'AI. Votre filtrage est mauvais.
3. Un assistant PRD qui sait ce qui s’est passé avant
Celui-ci a besoin d'un peu plus de configuration, mais il est encore très faisable.
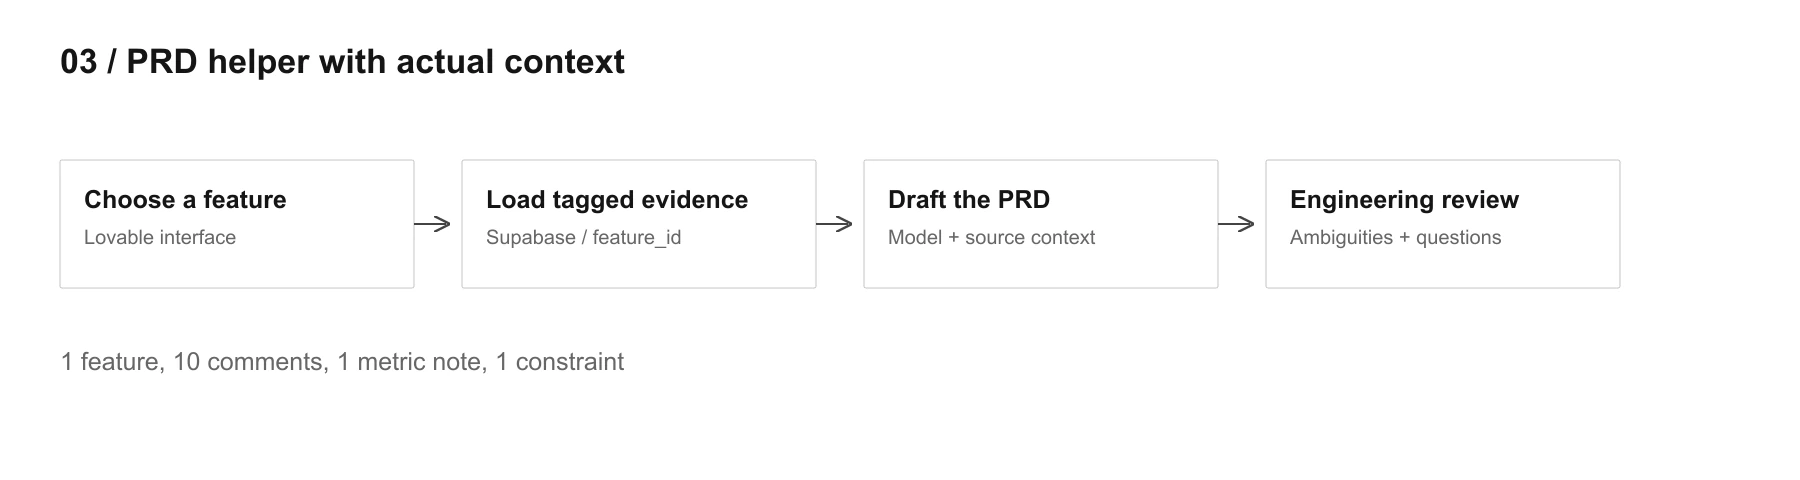
Il faut probablement utiliser Lovable + Supabase + Claude/ChatGPT, puis connecter Linear/Jira ou Productboard.
La petite version est essentiellement une page où vous choisissez une fonction, et l'application tire les commentaires des clients liés, les anciennes notes, peut-être des commentaires analytiques, puis envoie tout cela comme contexte au modèle.
Vous n'avez pas besoin d'une architecture de recherche de génie dans la version un.
Donc peut-être que la rétroaction a :
feature_id = onboarding_v2
et toutes les notes sur l'embarquement sont liées à cela.
Ensuite, prompt :
Vous rédigez un PRD uniquement à partir des preuves existantes.
Utilisez les commentaires des clients, les notes analytiques et les contraintes techniques ci-dessous.
Ne pas inventer les exigences.
Marquez clairement les hypothèses.
Si une information importante manque, créez une OPEN QUESTION au lieu de deviner.
Ensuite, après le projet :
Lisez ce PRD comme un ingénieur qui n'a jamais vu la fonction avant.
Indiquer tout ce qui peut être compris de deux manières différentes ou ne peut être mis en œuvre sans une autre décision.
Honnêtement, ce deuxième prompt est probablement là où la plupart de la valeur est.
Je commence par une fonction manuellement. Mettez 10 commentaires dans Supabase, ajoutez une note d'analyse, une contrainte d'ingénierie, puis génèrez le PRD. Si cela se sent déjà utile, connectez le reste.
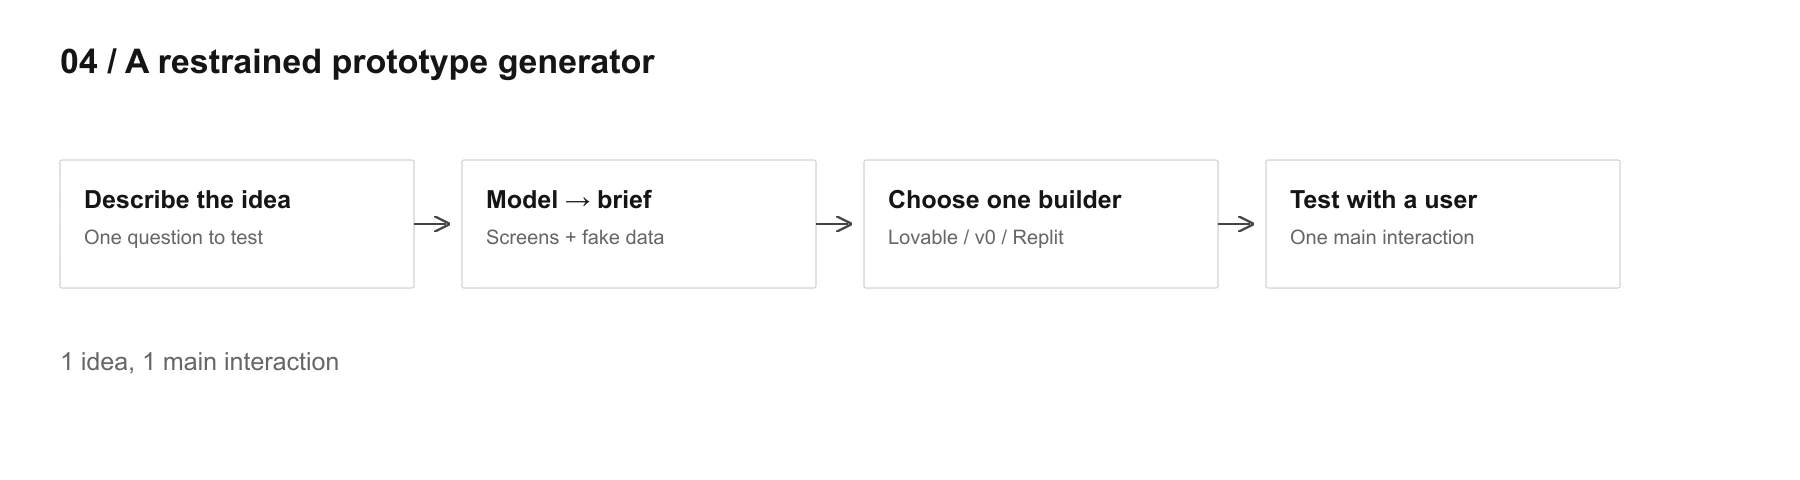
4. Un générateur de prototypes, mais avec des limites
Celui-ci est moins d'automatisation de flux de travail et plus un peu de produit pour vous-même.
Utiliser Lovable, v0 ou Replit et construire une très petite interface avec:
une zone de texte pour l'idée
peut-être quelques options comme mobile/web/dashboard
bouton: générer le prototype de brief
En fait, je n'essaierais pas de le faire générer automatiquement l'application entière à partir du premier jour. D'abord faites-le générer une spécification très stricte que vous puis alimentez dans Lovable/Replit.
Je veux tester cette idée : [IDEA]
Créez le plus petit prototype cliquable possible qui me permettrait de tester l'interaction principale avec un utilisateur.
Utiliser de fausses données.
Ne pas ajouter la facturation, les paramètres, les panneaux d'administration, les notifications, les rôles ou d'autres fonctions secondaires, sauf si elles sont nécessaires pour le test.
Donnez-moi:
les écrans nécessaires
ce qui se passe sur chaque écran
échantillon de données fausses
ce qui peut rester complètement faux
Quelle question ce prototype devrait m'aider à répondre
Ensuite, vous collez le résultat en Lovable ou Replit.
De cette façon, vous utilisez l'IA deux fois : d'abord pour réduire l'idée à la plus petite chose testable, puis pour la construire effectivement.
Et ouais, c'est un de ces cas où garder l'IA sous contrôle est plus utile que de lui demander de devenir créatif.
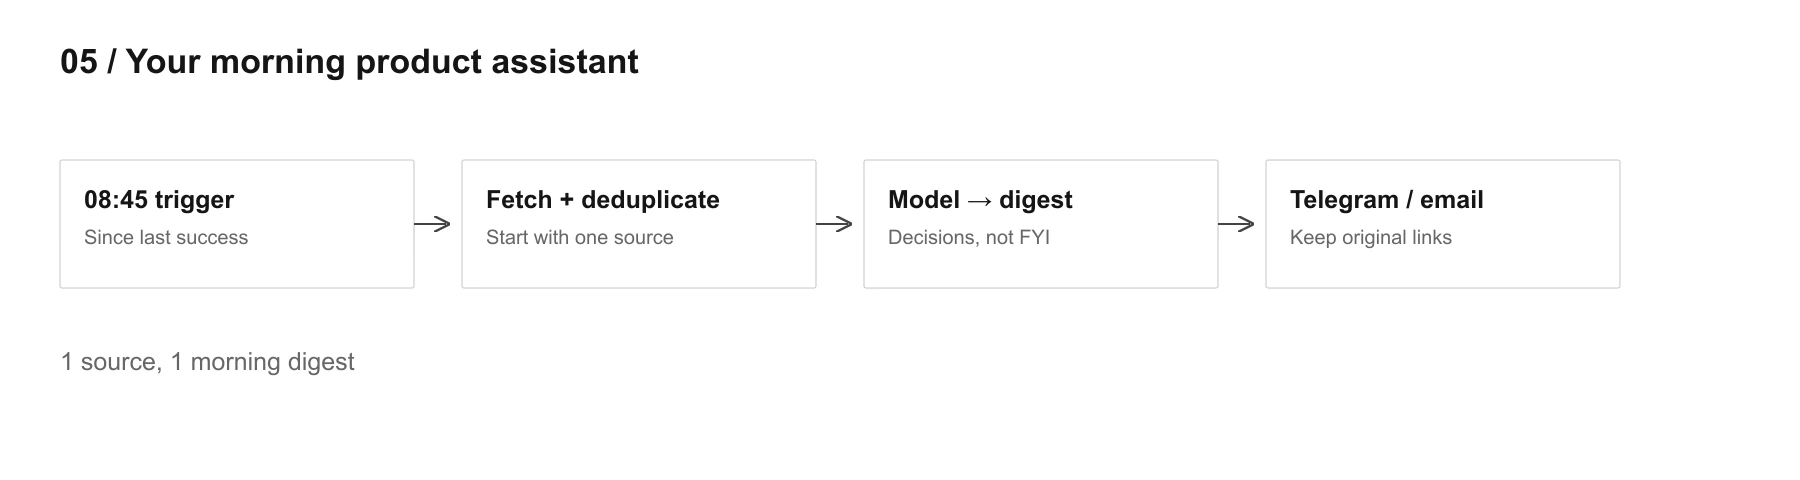
5. Votre propre assistant produit du matin
Celui-ci est probablement le plus facile à utiliser chaque jour.
Commencez par Gmail + Linear/Jira, ou Slack seulement si c'est là que se produit la plupart du chaos.
Utilisez n8n sur un horaire, peut-être 8:45 chaque matin, tirer de nouveaux articles depuis hier, les envoyer au modèle, puis livrer un dig à Telegram, Slack ou email.
Résumez seulement les choses qui peuvent affecter les décisions de produits aujourd'hui.
Ignorez le bruit et la conversation sociale.
Afficher & #160;:
blocants
les questions relatives aux clients
les décisions qui m'attendent
changements importants depuis hier
Si rien d'important ne s'est passé, dites-le.
Ensuite, vous pouvez ajouter la partie de fin de journée.
Quelque chose comme :
D'après les tâches, les notes et les décisions d'aujourd'hui, dites-moi ce qui a vraiment changé.
Qu'avons-nous appris ?
Quelle hypothèse est devenue plus faible ?
Qu'est-ce qui ne doit pas encore être décidé?
Enregistrez ça à Notion ou Supabase et soudainement vous avez ce petit journal de produits bizarre croissant en arrière-plan.
Et honnêtement, j'ai commencé avec la partie du matin seulement. Si cela vous fait économiser 20 minutes pour une semaine, puis ajouter plus.
Bonus, parce que j’en veux toujours un : un outil pour faire le point sur ses finances personnelles
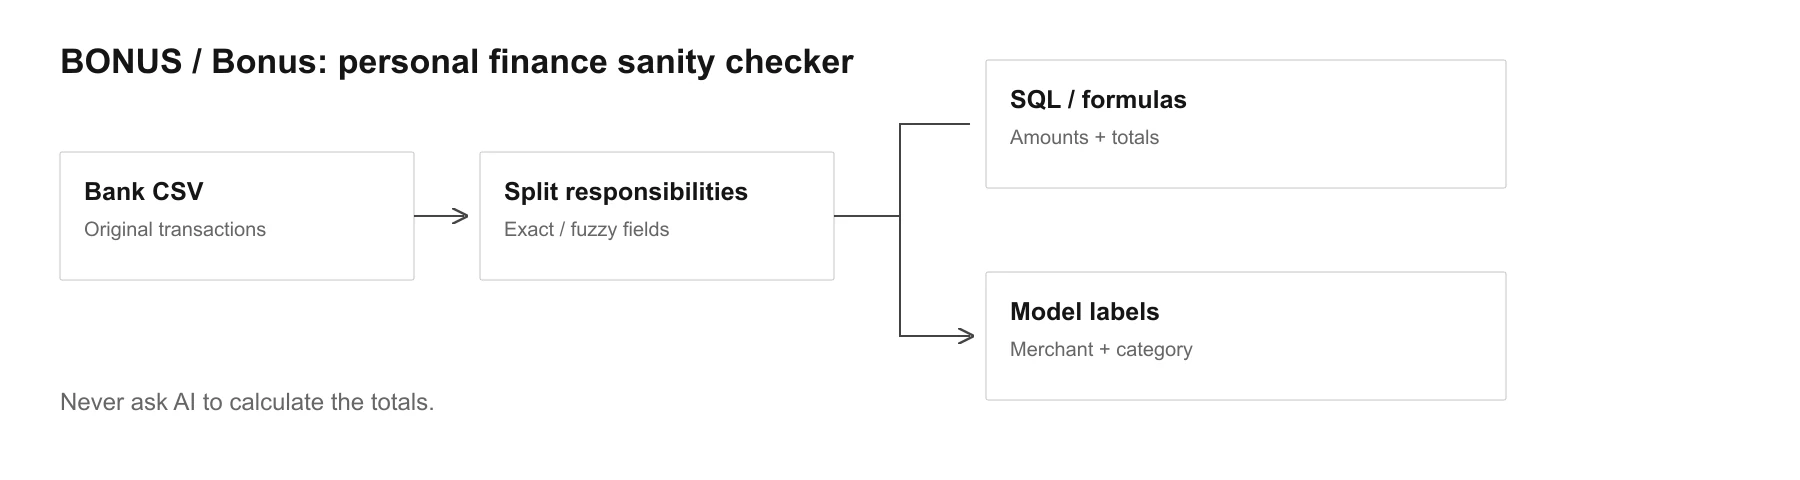
C'est probablement Google Sheets ou Supabase + n8n + LLM.
Exporter des transactions bancaires comme CSV. Les mettre dans un tableau. Utilisez des formules normales ou SQL pour tous les totaux exacts. Laissez AI nettoyer principalement les noms de marchands et classer les descriptions de transaction bizarres.
Par exemple :
AMZN Mktp DE*8H2... → Amazon
GOOGLE *TEMPORARY HOLD → probably temporary hold
some completely cursed bank merchant string → maybe restaurant / transport / subscription
Classez cette transaction selon le nom et la description du marchand.
Retour & #160;:
normalized_merchant
category
recurring: true/false/unknown
confidence
N'estimez pas le montant, la date ou la devise. Ceux-ci proviennent des données de transaction initiales.
Alors votre tableau de bord peut calculer exactement les choses ennuyeuses et l'IA peut aider à répondre à des questions humaines comme:
Qu'est-ce qui est devenu nettement plus cher ce mois-ci?
Quelles dépenses récurrentes sont apparues récemment?
Quels noms de marchands ressemblent à la même société sous des descriptions différentes ?
Je commencerais par 2 ou 3 mois de données. Cela suffit pour voir si la catégorisation est réellement utile.
Et je pense que c'est un peu le modèle général pour tout ça.
Ne commencez pas par demander à votre architecture complète ?
Commencer par :
Qu'est-ce qui m'embête de faire manuellement cette semaine ?
Alors construire la version stupide d'abord.
30 messages de rétroaction.
5 URLs concurrentes.
1 fonction PRD.
1 prototype.
Un digest du matin.
Si ça se sent déjà utile, alors ouais, maintenant c'est logique de le faire plus grand.