Vale, déjame compartir algunos conceptos que realmente encuentro interesantes aquí, porque “construye tu propia herramienta de IA” todavía suena más complicado de lo que es. Muchos de estos son sólo unos pocos servicios conectados de la manera correcta, y la parte divertida es que ya se puede construir algo realmente útil antes de incluso entender completamente lo que todas las piezas hacen.
Empezaría con cosas que resuelven un problema molesto primero. No “sistema operativo AI para mi arranque”. Una cosa. Hacer que funcione. A continuación, añadir cosas.
1. Tu propio cerebro para el feedback de clientes
Si estás construyendo un producto, tarde o temprano los comentarios estarán por todas partes. Entradas de soporte, entrevistas, reseñas, mensajes al azar de Slack, notas de ventas, tal vez Reddit, lo que sea.
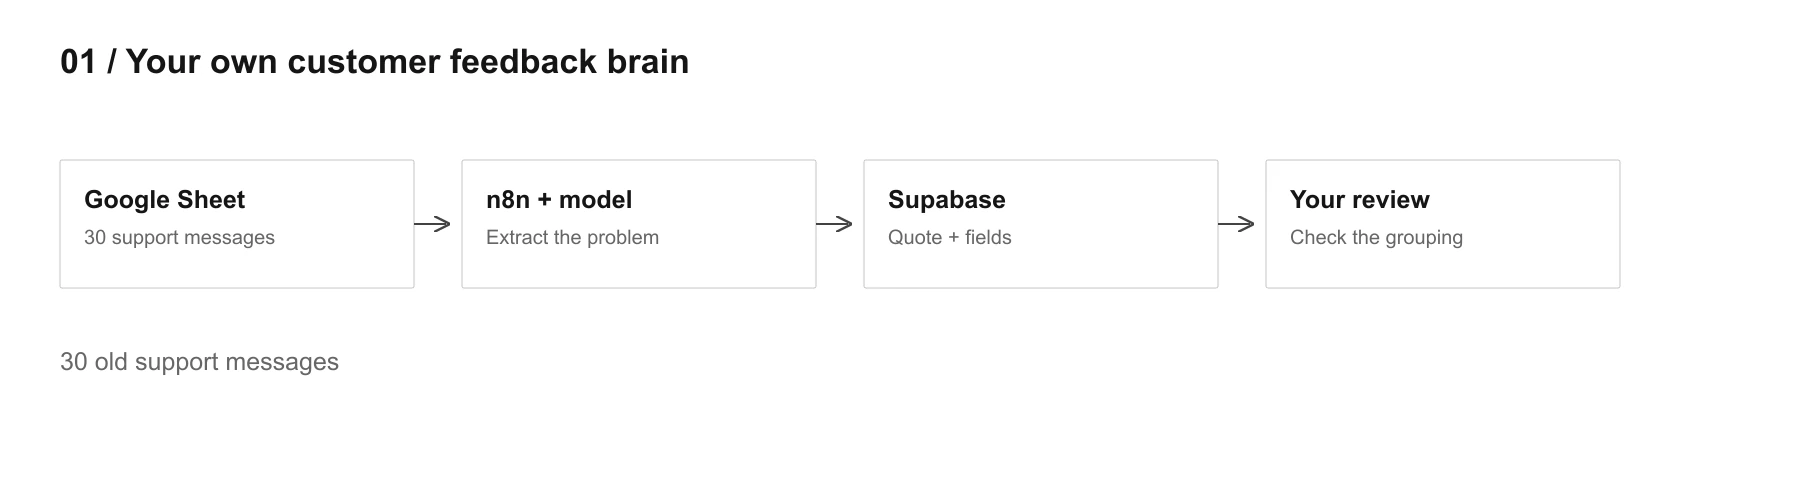
La primera versión más fácil sería n8n + Claude/ChatGPT + Supabase.
n8n recoge nuevos comentarios, lo envía al modelo, el modelo extrae algunos campos útiles, luego Supabase almacena tanto el texto original como la estructura limpia.
Empezaría con algo así de simple:
source
original_text
product_area
problem
severity
related_feature
confidence
Y sí, mantener el texto original. Esto importa mucho porque después de algún tiempo los resúmenes de IA comienzan a sonar sospechosamente más agradable que el cliente real.
Lea los comentarios de los clientes y extraiga el problema subyacente en lenguaje sencillo.
Volver:
product_area
problem
severity de 1 a 5
related_feature si está claro
confidence de 0 a 1
Si no estás seguro, escribe UNKNOWN.
No invente contexto que no esté en la retroalimentación original.
Mantenga la redacción original del cliente por separado.
¿Por dónde empezar? Honestamente, tome 30 antiguos mensajes de soporte, póngalos en una Hoja de Google, ejecute el flujo de trabajo en los primeros. Si la agrupación parece estúpida, arregle el prompt antes de conectar cinco fuentes diferentes.
Más tarde puedes conectar Gmail, Intercom, Slack, formularios, etc.
2. Un pequeño espía de la competencia
Este probablemente es aún más fácil.
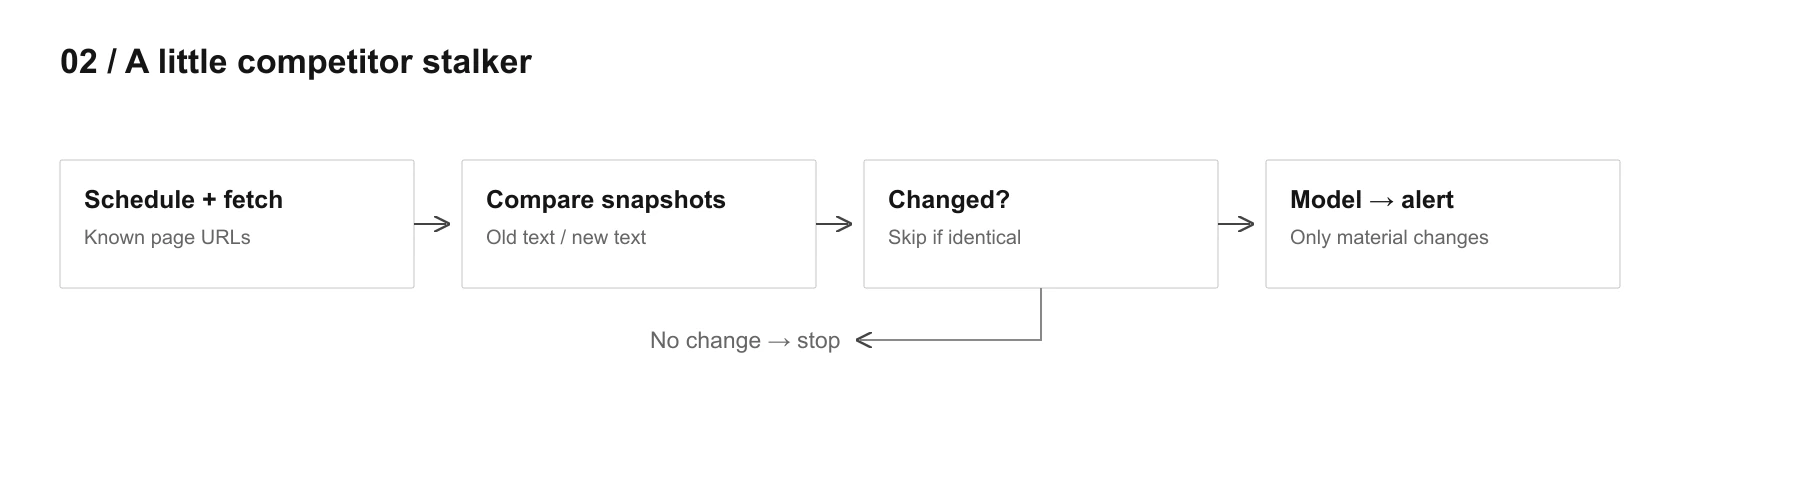
Elija 5 competidores y sólo 2 o 3 páginas para cada uno al principio. Precios, página de inicio, registro de cambios. Eso es suficiente.
Puede utilizar n8n + una simple HTTP fetch + Supabase para almacenar instantáneas. Cada día o cada pocos días, volver a buscar la página y compararla con la versión anterior. Sólo si algo cambia, envíe el texto cambiado a Claude/ChatGPT y pregunte si realmente importa.
NO enviaría toda la Internet al modelo todos los días. Eso es derrochador y un poco tonto.
Compare estas dos versiones de la misma página competidora.
Ignorar pequeños cambios de redacción, cambios de formato y texto legal irrelevante.
Dime sólo si algo significativo cambió para el producto, precios, posicionamiento, a bordo o cliente objetivo.
Volver:
changed: true/false
summary
why_it_matters
confidence
Al principio incluso me saltaría el gateo de fantasía. Sólo añadir manualmente las URLs que te importan y ver si las alertas son útiles.
Si después de dos semanas obtienes la mayor parte de basura, tu problema no es “necesitamos más IA”. Tu filtrado es malo.
3. Un asistente para el PRD que sabe qué pasó antes
Este necesita un poco más de configuración, pero todavía es muy factible.
Probablemente usaría Lovable + Supabase + Claude/ChatGPT, y luego conectaría Linear/Jira o Productboard.
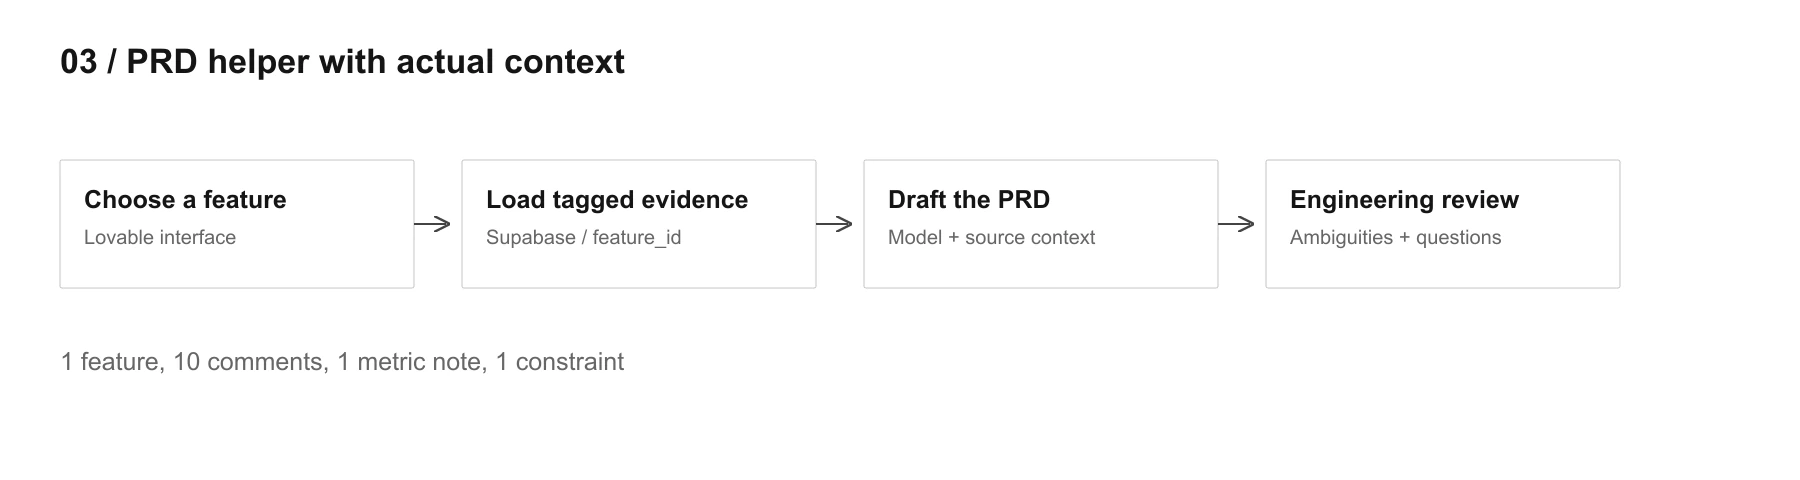
La versión pequeña es básicamente una página donde eliges una función, y la aplicación saca comentarios relacionados con los clientes, notas antiguas, tal vez comentarios analíticos, y luego envía todo eso como contexto al modelo.
Usted no necesita alguna arquitectura de recuperación de genio en la versión uno. Las etiquetas son suficientes.
Así que tal vez la retroalimentación tiene:
feature_id = onboarding_v2
Y todas las notas sobre el embarque se vinculan a eso.
Entonces indica:
Estás redactando un PRD de las pruebas existentes solamente.
Utilice los comentarios de los clientes, las notas analíticas y las limitaciones técnicas a continuación.
No inventar los requisitos.
Marcar suposiciones claramente.
Si falta algo importante, crea una OPEN QUESTION en lugar de adivinar.
Después del borrador:
Lea este PRD como un ingeniero que nunca ha visto la función antes.
Señalar cualquier cosa que pueda ser entendida de dos maneras diferentes o no puede ser implementada sin otra decisión.
Honestamente, ese segundo aviso es probablemente donde está la mayor parte del valor.
Empezaría con una característica manualmente. Ponga 10 comentarios en Supabase, agregue una nota analítica, una restricción de ingeniería, y luego genere el PRD. Si eso ya se siente útil, conecte el resto.
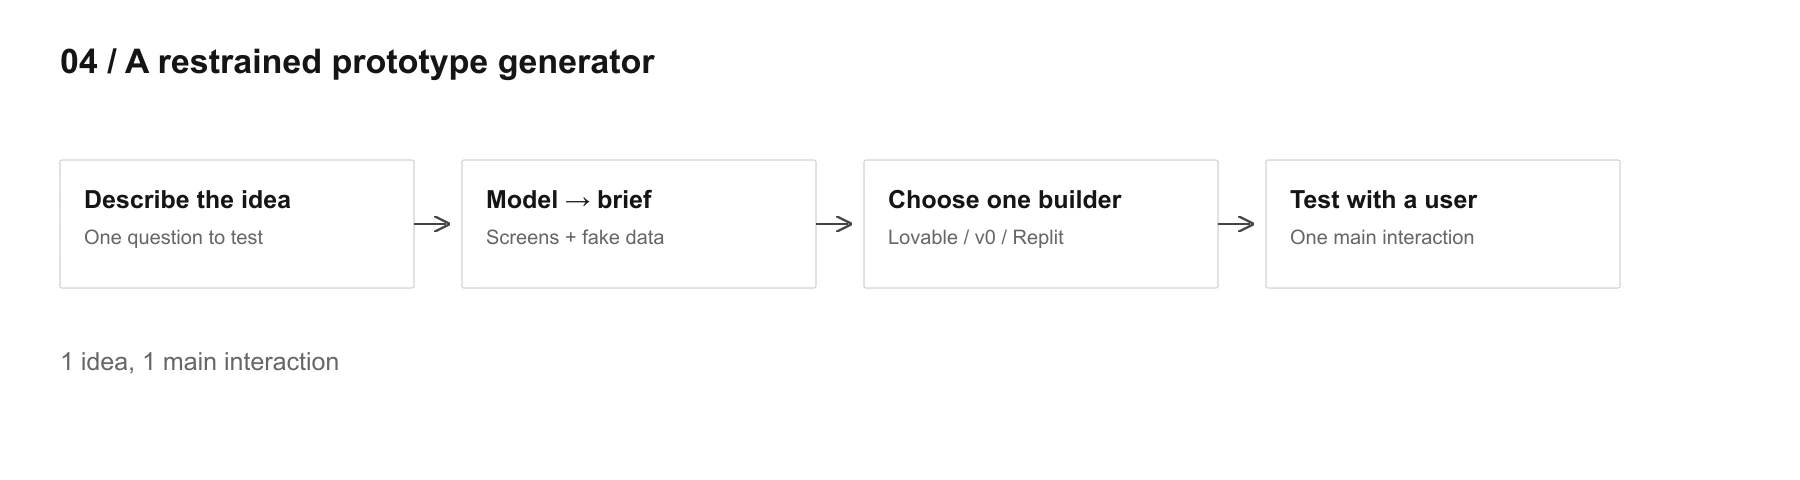
4. Un generador de prototipos, pero con límites
Este es menos “automatización de flujo de trabajo” y más un poco de producto para usted.
Utilice Lovable, v0 o Replit y construya una interfaz muy pequeña con:
un área de texto para la idea
Tal vez algunas opciones como móvil/web/dashboard
botón: generar prototipo breve
En realidad no trataría de hacerlo generar automáticamente toda la aplicación desde el primer día. Primero hacer que genere una especificación muy estricta que luego se alimenta en Lovable / Respuesta.
Quiero probar esta idea: [IDEA]
Crear el prototipo de clics más pequeño posible que me permitiría probar la interacción principal con un usuario.
Usa datos falsos.
No añada facturación, configuración, paneles de administración, notificaciones, roles u otras características secundarias a menos que se requieran para la prueba.
Dame:
Pantallas necesarias
lo que sucede en cada pantalla
muestra de datos falsos
lo que puede permanecer completamente falso
qué pregunta este prototipo debería ayudarme a responder
Luego pegas el resultado en Lovable o Replit.
De esta manera se usa IA dos veces: primero para reducir la idea a la cosa más pequeña que se puede probar, y luego para construirla.
Y sí, este es uno de esos casos en los que mantener la IA bajo control es más útil que pedirle que sea “creativo”.
5. Tu propio asistente de producto para cada mañana
Este es probablemente el más fácil de usar cada día.
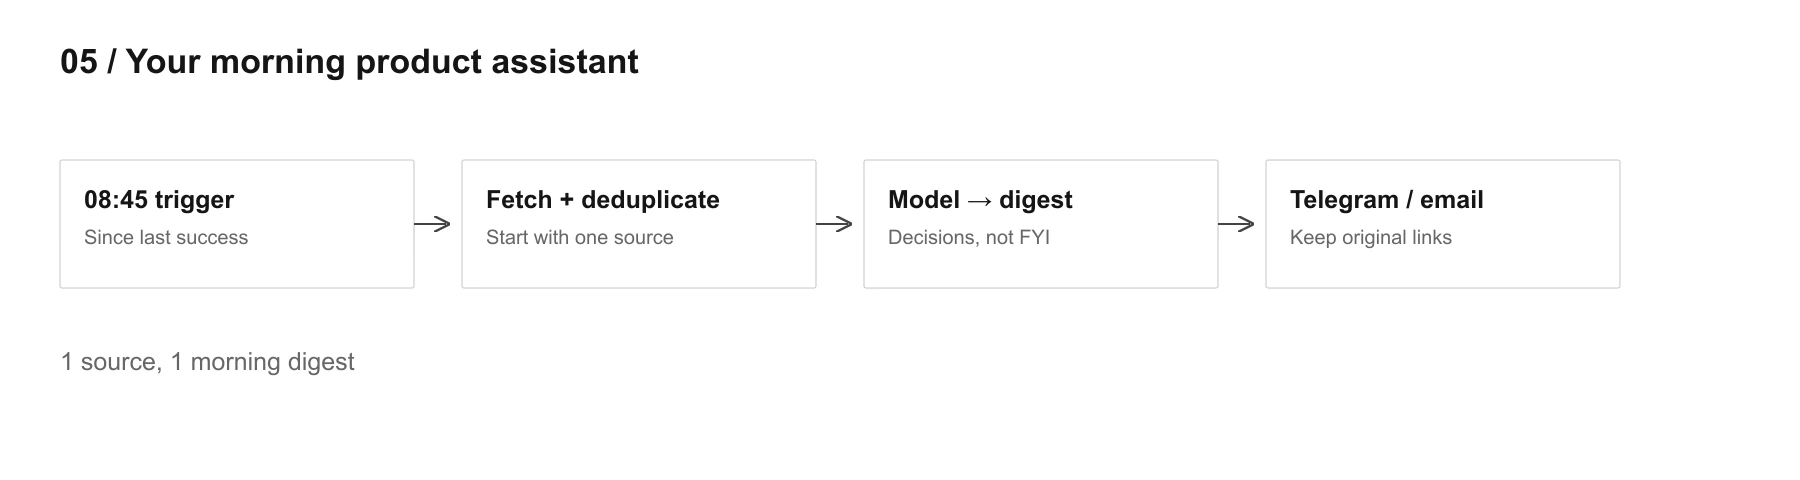
Comience con sólo Gmail + Lineal/Jira, o sólo Slack si es donde ocurre la mayor parte del caos. No conecte 12 cosas inmediatamente.
Utilice n8n en un horario, tal vez 8:45 todas las mañanas, sacar nuevos elementos desde ayer, enviarlos al modelo, luego entregar un compendio a Telegram, Slack o correo electrónico.
Resumir sólo las cosas que pueden afectar las decisiones de productos hoy en día.
Ignora el ruido y la conversación social.
Mostrar:
bloqueadores
Problemas con los clientes
decisiones que me esperan
cambios importantes desde ayer
Si no pasó nada importante, dilo.
Luego puedes añadir la parte del final del día.
Algo así como:
Basándome en las tareas, notas y decisiones de hoy, dime qué cambió realmente.
¿Qué hemos aprendido?
¿Qué suposición se hizo más débil?
¿Qué todavía no se debe decidir todavía?
Guarde eso en Notion o Supabase y de repente usted tiene este diario de productos raro que crece en el fondo.
Y honestamente, empezaría con la parte de la mañana solamente. Si te ahorra 20 minutos por una semana, entonces añade más.
Bonus, porque todavía quiero este: un chequeo de tus finanzas personales
Esto es probablemente Google Sheets o Supabase + n8n + LLM.
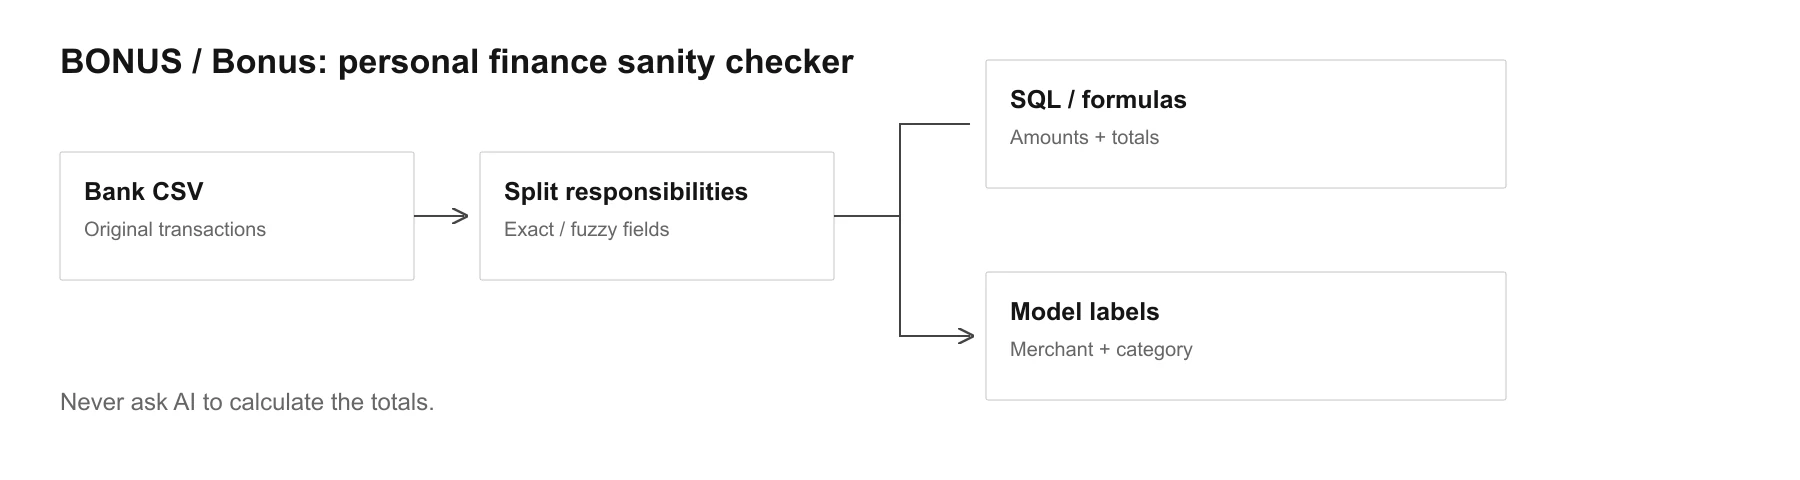
Exportar transacciones bancarias como CSV. Ponerlas en una tabla. Utilice fórmulas normales o SQL para todos los totales exactos. Deje que la IA limpie sobre todo nombres comerciales y clasificar descripciones de transacciones raras.
Por ejemplo:
AMZN Mktp DE*8H2... → Amazon
GOOGLE *TEMPORARY HOLD → probably temporary hold
some completely cursed bank merchant string → maybe restaurant / transport / subscription
Clasificar esta transacción en función del nombre comercial y la descripción.
Volver:
normalized_merchant
category
recurring: true/false/unknown
confidence
No estimar la cantidad, fecha o moneda. Los que vienen de los datos originales de la transacción.
Entonces tu tablero puede calcular las cosas aburridas exactamente y la IA puede ayudar a responder preguntas humanas como:
¿Qué se volvió notablemente más caro este mes?
¿Qué gastos recurrentes aparecieron recientemente?
¿Qué nombres comerciales parecen la misma compañía bajo diferentes descripciones?
Empezaría con 2 o 3 meses de datos. Eso es suficiente para ver si la categorización es realmente útil.
Y creo que ese es un poco el patrón general para todos estos.
No empieces preguntando “¿qué arquitectura completa necesito?”
Comience con:
¿Qué cosa molesta quiero dejar de hacer manualmente esta semana?
Entonces construye primero la versión estúpida.
30 mensajes de retroalimentación.
5 URLs de competidores.
1 función PRD.
Un prototipo.
Un digest matutino.
Si eso ya se siente útil, entonces sí, ahora tiene sentido hacerlo más grande.